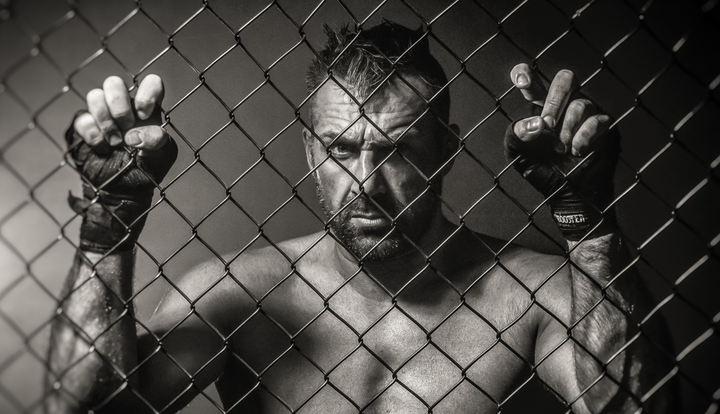
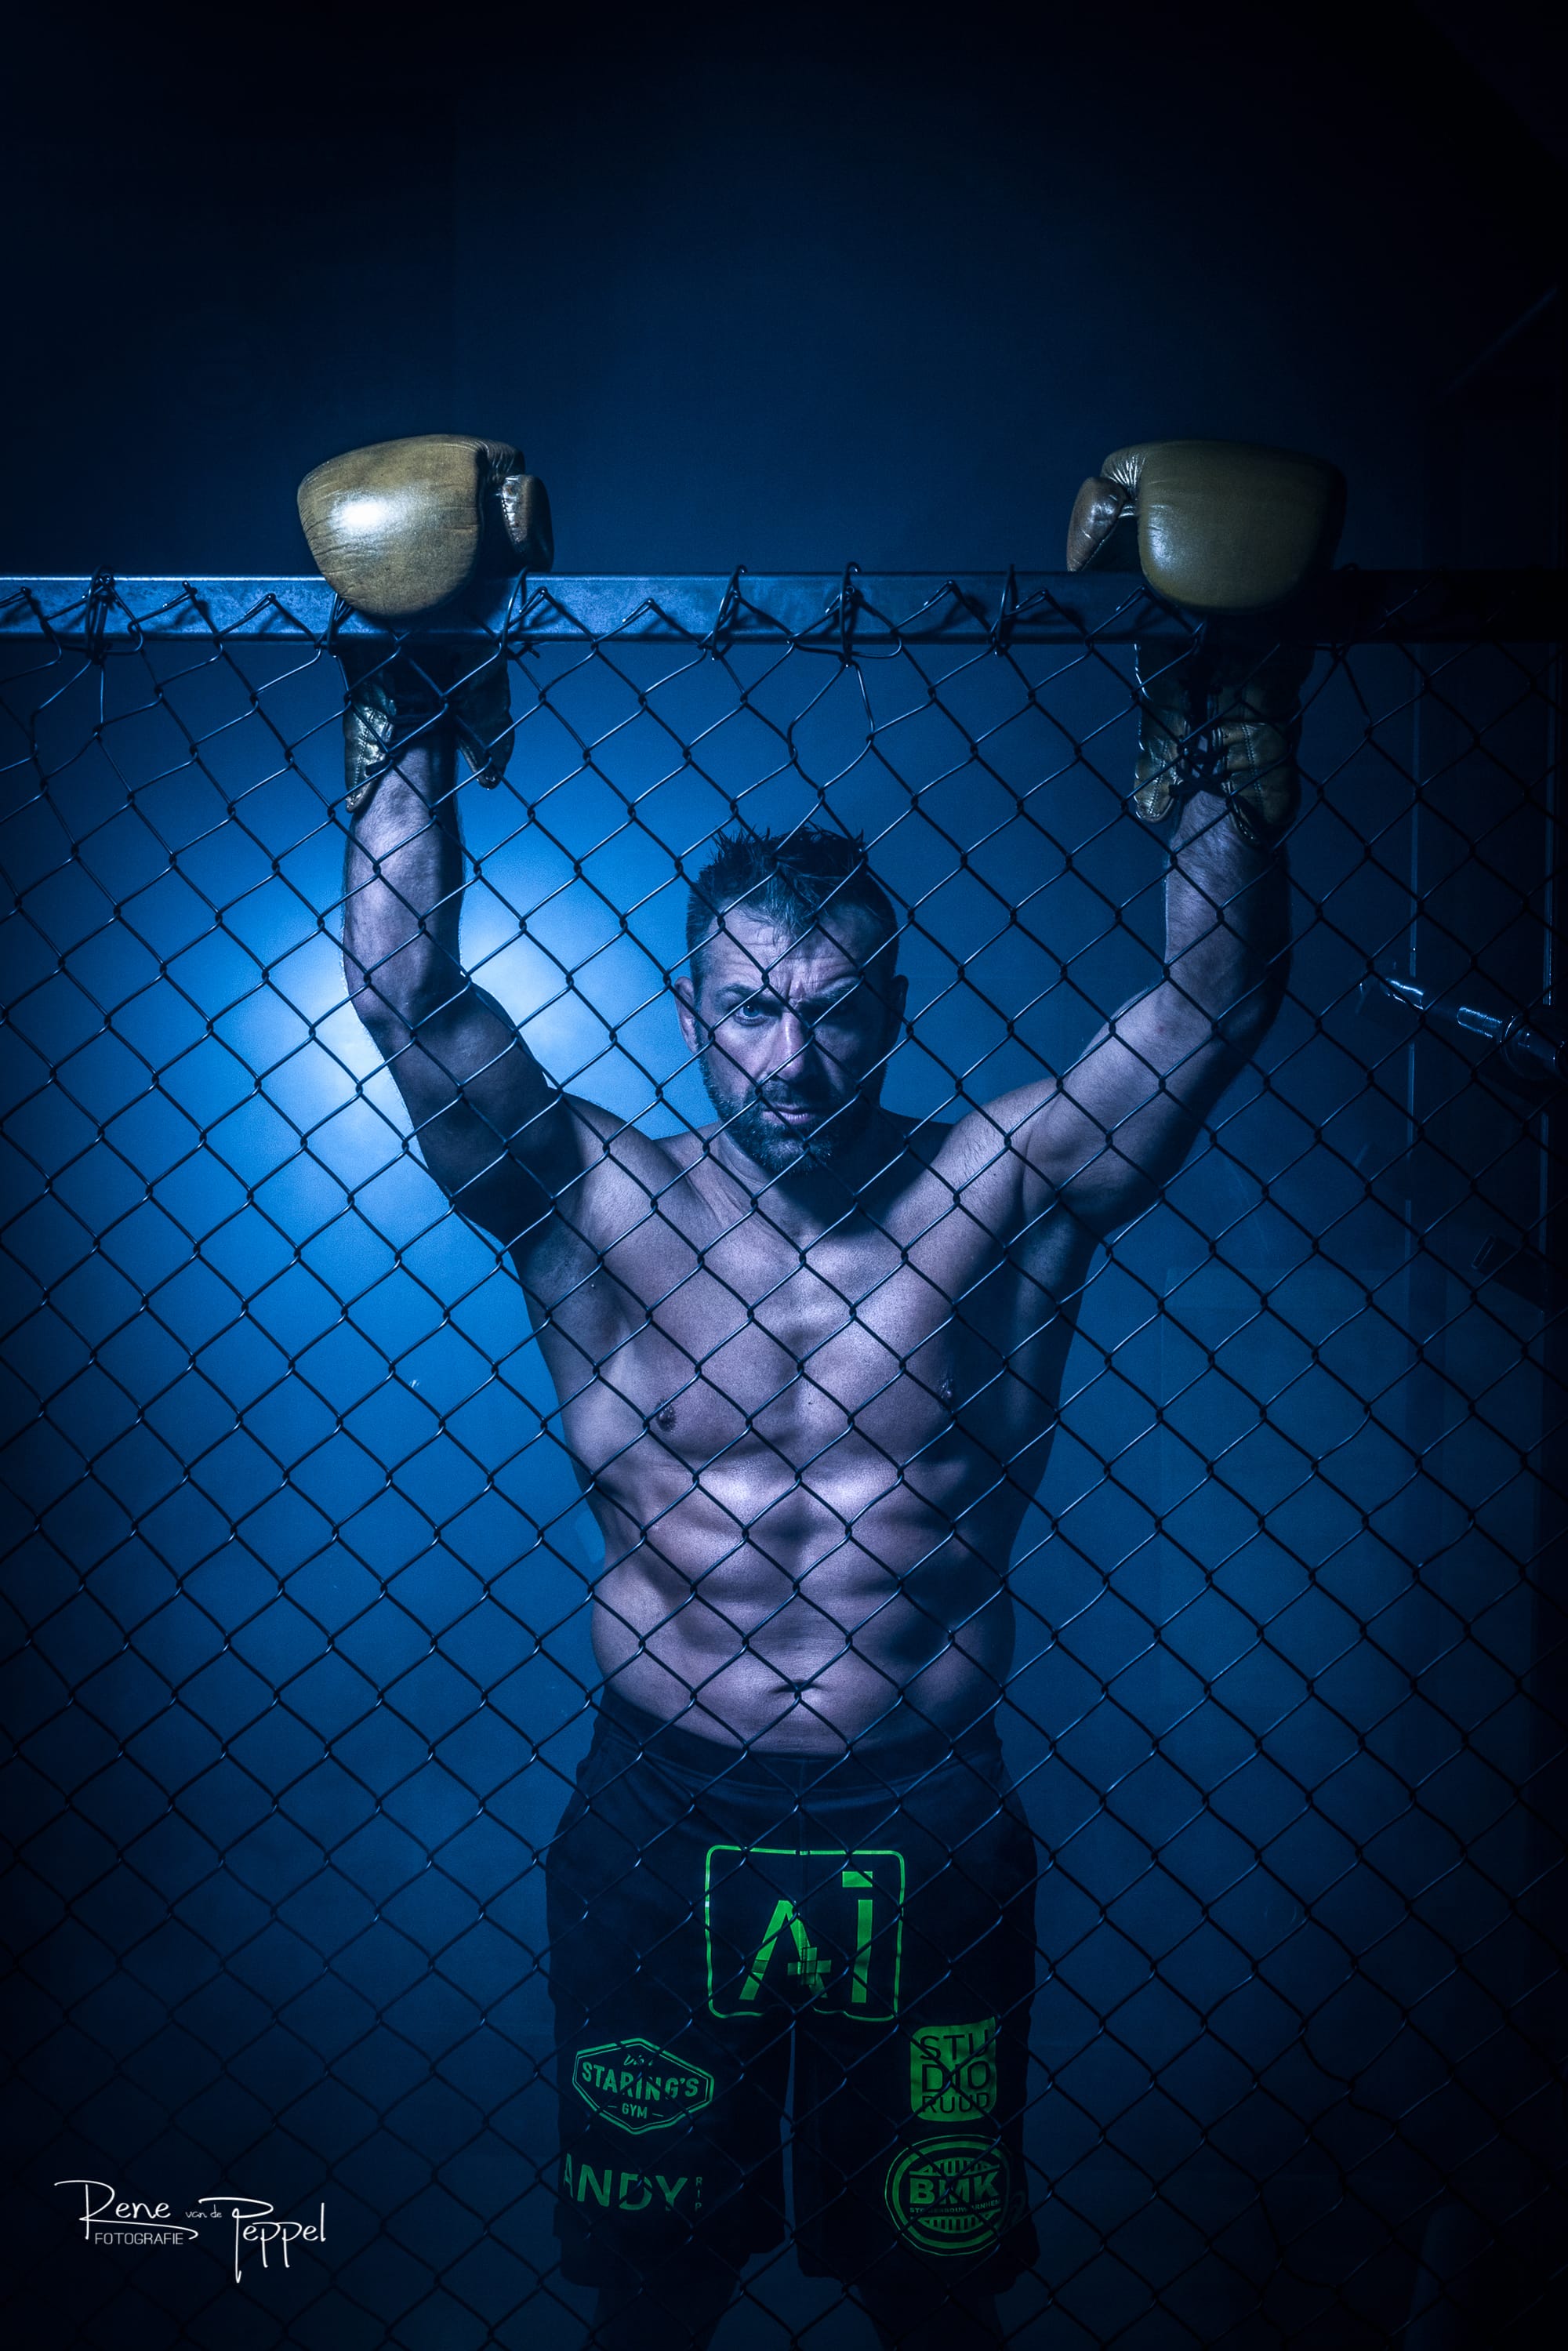
Hij staat in de kooi. Handen aan het hek, blik recht vooruit.
Op zijn broek staat AI, dat zag ik pas later toen ik de foto bekeek op mijn scherm. Maar het bleef hangen. Niet vanwege de tekst, maar vanwege wat het onbewust uitstraalt: focus, kracht, en vooral… de juiste plek op het juiste moment.
En dat is precies waar het bij AI ook om draait.
De afgelopen tijd ben ik lokaal met taalmodellen aan het testen. Qwen, Llama, Mistral, alles wat een beetje fatsoenlijk draait via Ollama. Wat me daarbij opvalt: het gesprek gaat vaak over “welk taalmodel het beste is”, maar dat is eigenlijk de verkeerde vraag.
De echte vraag is tweeledig: welk model gebruik je — en waar laat je het draaien?
Het beste model op de verkeerde hardware is gewoon een vechter zonder handschoenen.
Het zit zo
Een taalmodel (LLM) klinkt ingewikkeld, maar in de basis is het vrij simpel. Elk antwoord dat zo’n model geeft, komt voort uit een enorme hoeveelheid wiskunde. Geen magie, maar matrixvermenigvuldigingen. Heel veel. Tegelijk.
Een CPU (Central Processing Unit) is gemaakt voor veelzijdigheid. Hij kan schakelen, beslissingen nemen, verschillende taken tegelijk beheren. Maar hij doet dat grotendeels sequentieel. Stap voor stap.
Een GPU (Graphics Processing Unit) werkt anders. Die is gebouwd voor herhaling. Duizenden simpele berekeningen, allemaal tegelijk. Niet omdat hij slimmer is, maar omdat hij schaalbaar is.
En laat dat nou precies zijn wat AI nodig heeft.
Daarom zie je in de praktijk dat een middelmatige GPU een CPU compleet voorbijloopt zodra je met modellen gaat werken. Niet een beetje sneller, maar een orde van grootte. Waar een CPU rustig zijn berekeningen afwerkt, gooit een GPU er gewoon brute parallelle kracht tegenaan.
Geheugen is geen detail, maar de spelregels
Dan komt het tweede deel van het verhaal. Want rekenen alleen is niet genoeg — het model moet ergens staan.
Een taalmodel wordt volledig in geheugen geladen voordat het iets kan doen. Dat betekent dat de grootte van het model direct bepaalt wat je nodig hebt aan geheugen. En daar gaat het vaak mis.
GPU’s hebben hun eigen geheugen: VRAM. Dat is snel, direct gekoppeld aan de rekenkernen, en essentieel voor performance. Maar het is ook beperkt.
Zolang je model volledig in VRAM past, voelt alles soepel. Antwoorden komen direct, interactie voelt natuurlijk. Maar zodra het model niet meer past en er wordt uitgeweken naar systeemgeheugen, verandert dat compleet. Dan krijg je vertraging, haperingen, en het gevoel dat alles net niet lekker loopt.
Het verschil is moeilijk uit te leggen als je het niet hebt gezien, maar zodra je het ervaart is het overduidelijk. Het is het verschil tussen iemand die klaarstaat om te vechten — en iemand die nog bezig is zijn handschoenen te zoeken.
CPU inference: het werkt, maar het voelt
Lokaal draaien zonder GPU kan prima. Een klein model op een compacte machine doet gewoon zijn werk. Technisch gezien klopt alles.
Maar het tempo verandert.
Waar een GPU een gesprek laat voelen als een gesprek, maakt een CPU er iets van waarbij je wacht. Niet extreem, maar net genoeg om uit de flow te raken. Je merkt het in kleine dingen: een halve seconde hier, een seconde daar. Het stapelt zich op.
En dat is precies waarom veel mensen denken dat lokale AI “nog niet zover is”. Terwijl het probleem vaak niet het model is — maar waar het draait.
Niet elk model hoort in elke ring
Daar komt de tweede helft van het verhaal weer terug: de modellen zelf.
Er zijn er inmiddels genoeg. Qwen, Llama, Mistral, DeepSeek, Gemma — elk met hun eigen karakter. Maar wat vooral opvalt, is dat er niet één winnaar is.
Sommige modellen zijn goed in code, andere in taal, weer andere in redeneren. Sommige zijn snel en direct, andere nemen de tijd en “denken” zichtbaar na voordat ze antwoorden geven. Dat laatste klinkt indrukwekkend, maar is in de praktijk niet altijd wat je wilt — zeker niet als je ze inzet in automatisering of workflows.
Wat je dus eigenlijk doet, is hetzelfde als bij die vechter in de kooi. Je kiest niet alleen wie er vecht, maar ook in welke klasse hij uitkomt.
Een licht model op een CPU kan prima zijn voor simpele taken. Een middelgroot model op een GPU voelt ineens als een serieuze assistent. En zware modellen? Die vragen simpelweg om serieuze hardware — of een stukje cloud erbij.
Steeds vaker zie je daarom combinaties ontstaan. Lokaal voor snelheid en controle, en extern voor de momenten waarop je meer kracht nodig hebt. Niet omdat het moet, maar omdat het logisch is.
De echte les
Wat hier onder zit, is eigenlijk vrij simpel.
AI gaat niet alleen over intelligentie.
Het gaat over plaatsing.
Het juiste model, op de juiste hardware, met het juiste geheugen.
Als één van die drie niet klopt, merk je het meteen.
Terug naar de kooi
Die foto bleef hangen omdat alles klopte. Licht, houding, moment. Niets toevallig.
En dat is precies hoe een goede AI-setup ook voelt.
Niet groter dan nodig. Niet zwaarder dan nodig.
Maar precies goed.
Want uiteindelijk maakt het niet uit hoe sterk je model is…
als het niet kan leveren op het moment dat je het nodig hebt.
💬 En jij?
Draai je al lokaal? En zo ja — op CPU, GPU, of een mix?
Gebruik je één model, of heb je al een soort verdeling gemaakt tussen snel, slim en zwaar?
👉 Log in en deel je setup hieronder. Altijd interessant om te zien hoe anderen hun “AI-ring” hebben ingericht.
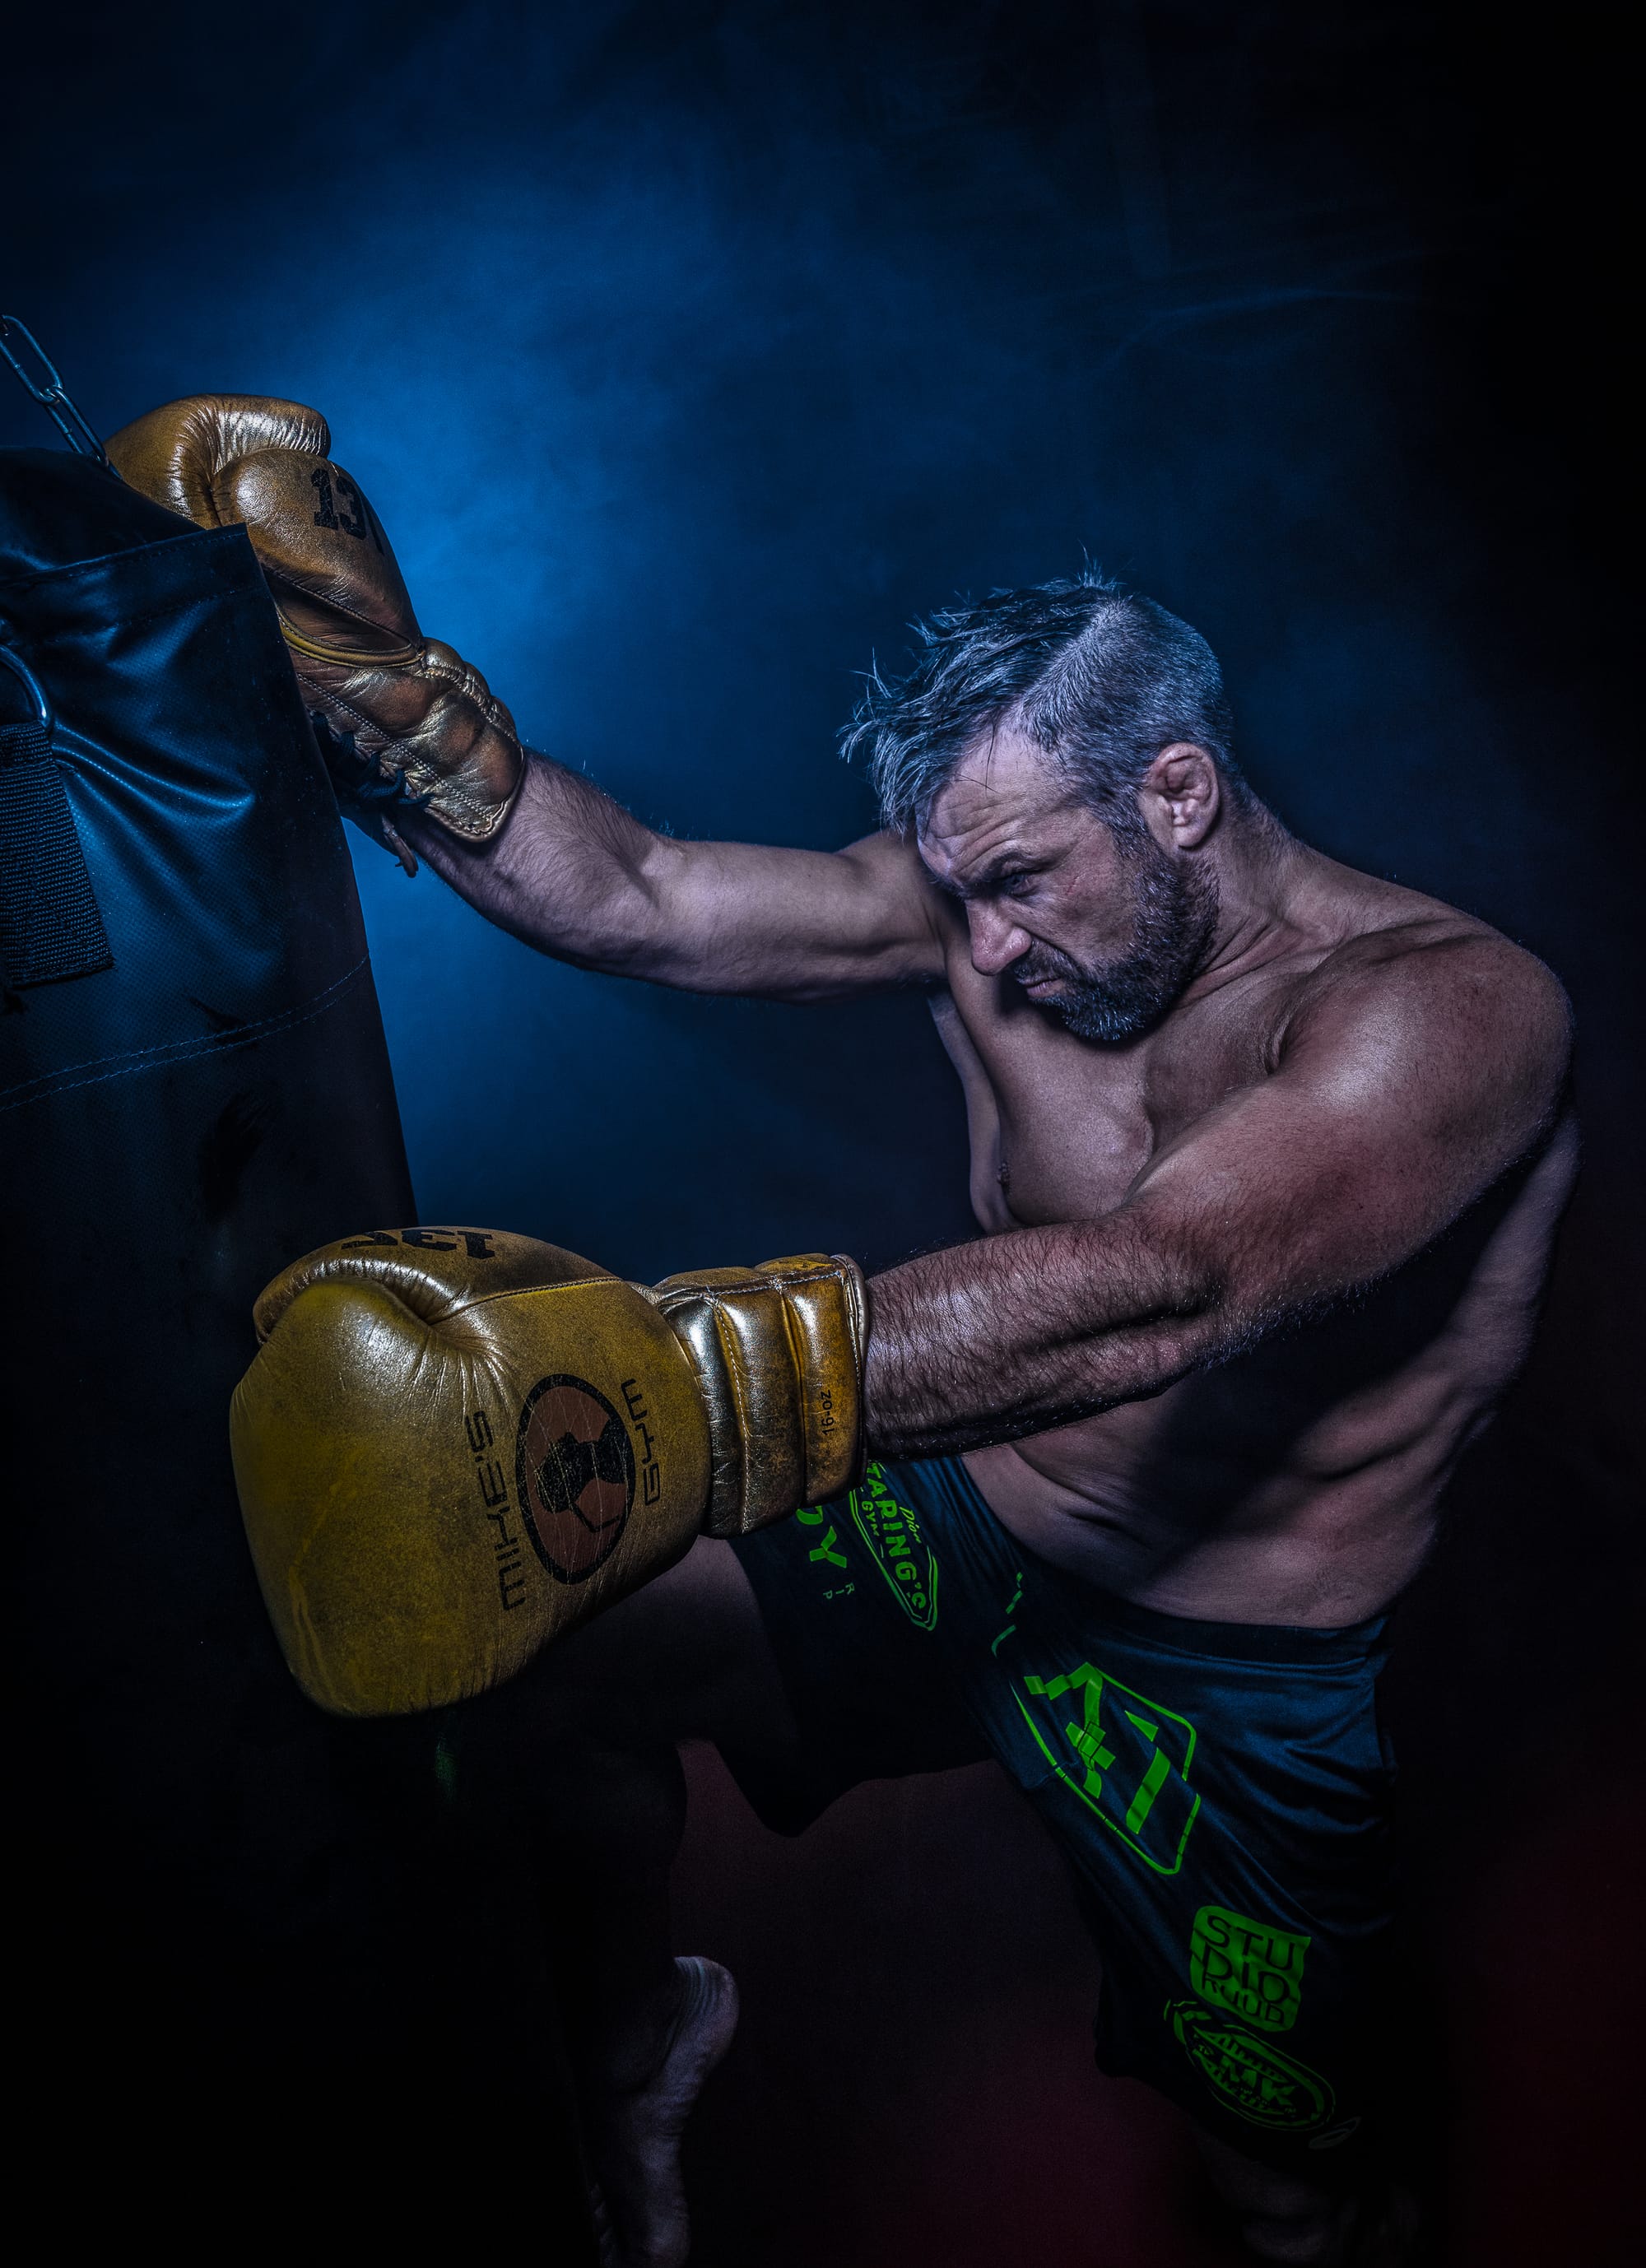
Verschillende modellen, verschillende momenten — vastgelegd voor LooLens.