Ik was benieuwd.
Weer terug uit Kreta, met een memorydisk vol foto's. Vuurtorens, zee, straatbeelden, Griekse kapelletjes, zonsondergangen… precies het soort foto's waarvoor je op vakantie toch steeds weer je camera pakt. Toen ik de foto van de vuurtoren van Chania terugzag, dacht ik ineens: kan AI deze foto opnieuw maken zonder de originele foto te zien?
Niet door de foto simpelweg te laten bewerken, maar door AI alleen te vertellen wat er op de foto staat. Kan een beeldgenerator op basis daarvan een nieuwe foto maken die behoorlijk dicht bij het origineel komt?
Dat klinkt simpel. Maar hoe kom je aan een prompt die gedetailleerd genoeg is?
Eén AI laten kijken, een andere AI laten maken
Daar kwam Claude om de hoek kijken. Ik heb een aantal foto's uit Kreta geüpload naar Claude, met eigenlijk maar één opdracht: analyseer deze foto zo nauwkeurig mogelijk en maak op basis daarvan een uitgebreide prompt waarmee een andere AI de foto opnieuw zou kunnen genereren.
En Claude ging vervolgens behoorlijk ver. Niet alleen: "een vuurtoren aan zee bij zonsondergang", maar ook waar de vuurtoren ongeveer in beeld staat, hoeveel ruimte de lucht inneemt, waar de horizon loopt, hoe groot de mensen op de kade zijn, hoe het licht op de stenen valt, welke kleur het water heeft, welke brandpuntsafstand waarschijnlijk gebruikt is en zelfs welke kleine details in het beeld aanwezig zijn.
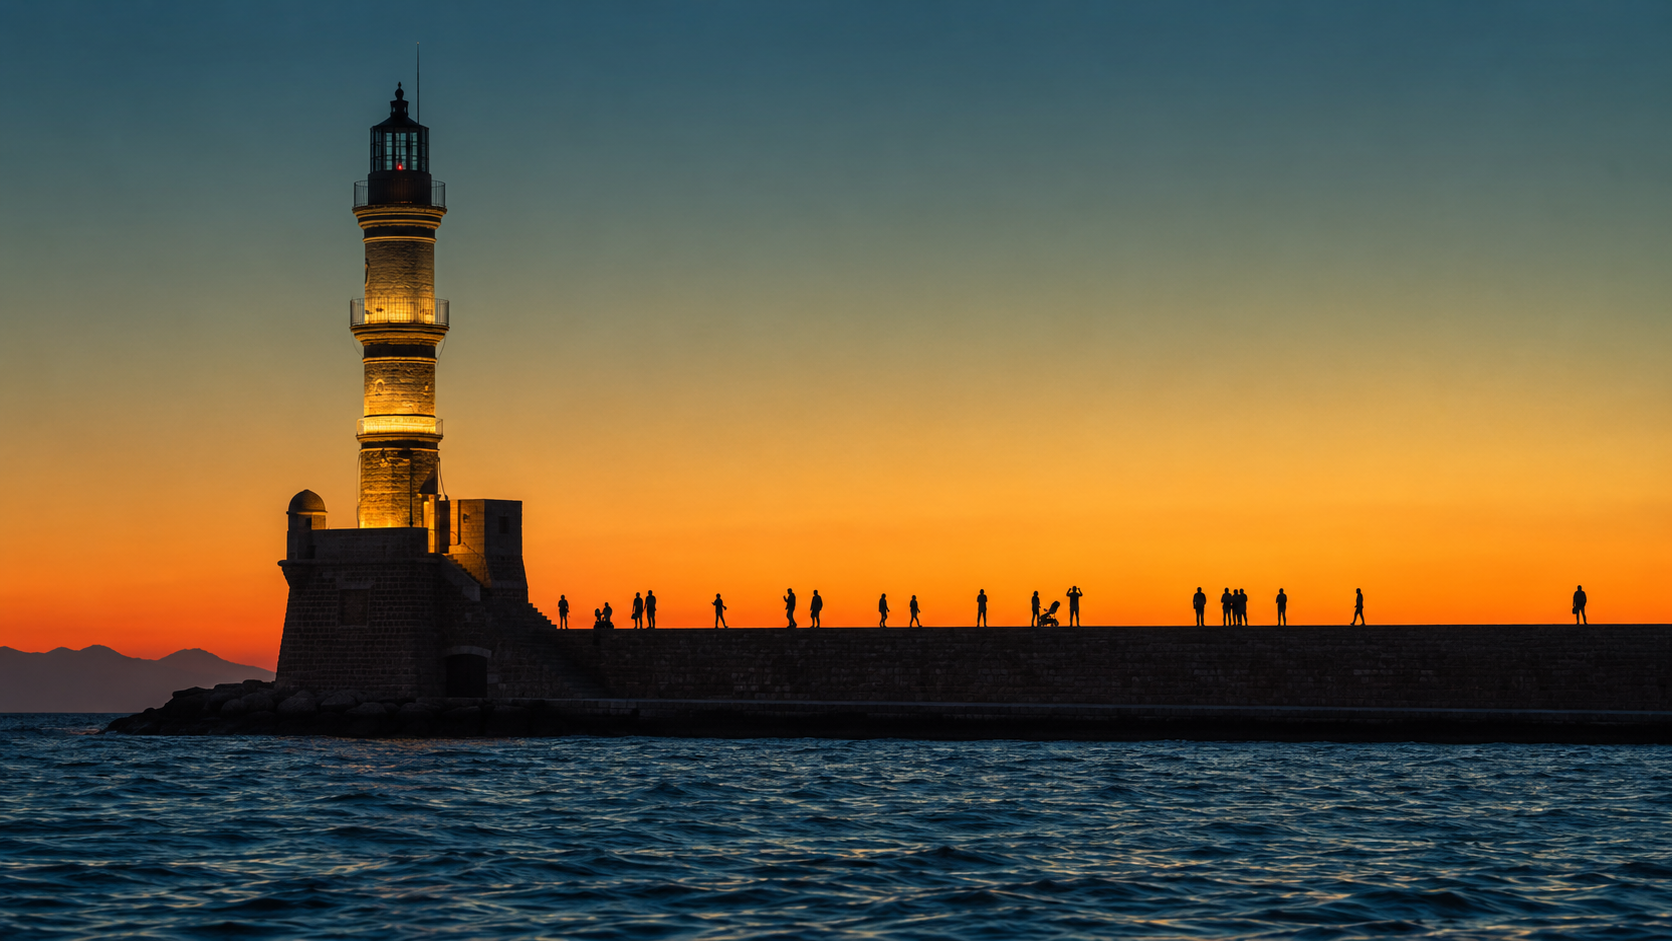
The lighthouse: a slender tapering tower, Ottoman-influenced Venetian design, three stacked tiers separated by narrow projecting balconies with thin dark iron railings, an octagonal upper section, and a glazed lantern room capped by a small black dome with a thin lightning rod. A tiny red navigation light glows inside the lantern glass. The tower is lit from below by warm artificial floodlight, so the weathered sandstone glows amber-tan on its lower two tiers while the upper section falls into near-silhouette. The base is a squat stone bastion with a small domed sentry turret on its left flank and a stone stairway on the right, rendered almost entirely black.
The sky: completely cloudless, an unbroken vertical gradient from desaturated slate-teal at the very top, through muted grey-green, into warm amber, and finally a saturated deep orange band along the horizon. The sun has already set — this is pure afterglow, no visible sun, no sunburst.
On the breakwater: roughly fifteen human figures in pure black silhouette, irregularly spaced, tiny in scale — no facial detail, no colour. Some walking, some standing still, two holding phones raised to photograph, one seated at the base of the lighthouse wall, one pushing a stroller, a lone figure far right near the frame edge. They read as a scattered frieze along the wall, giving scale. Far left horizon: a faint, low mountain ridge in hazy blue-grey, barely separated from the sky.
The sea: dark navy-teal, textured with small choppy wind waves, catching thin broken amber highlights from the sky. No reflections of the lighthouse. No boats.
Mood: quiet, monumental, warm-cool colour contrast. Clean modern digital rendering, no grain, no vignette, no lens flare, no HDR halos. Photographic realism.
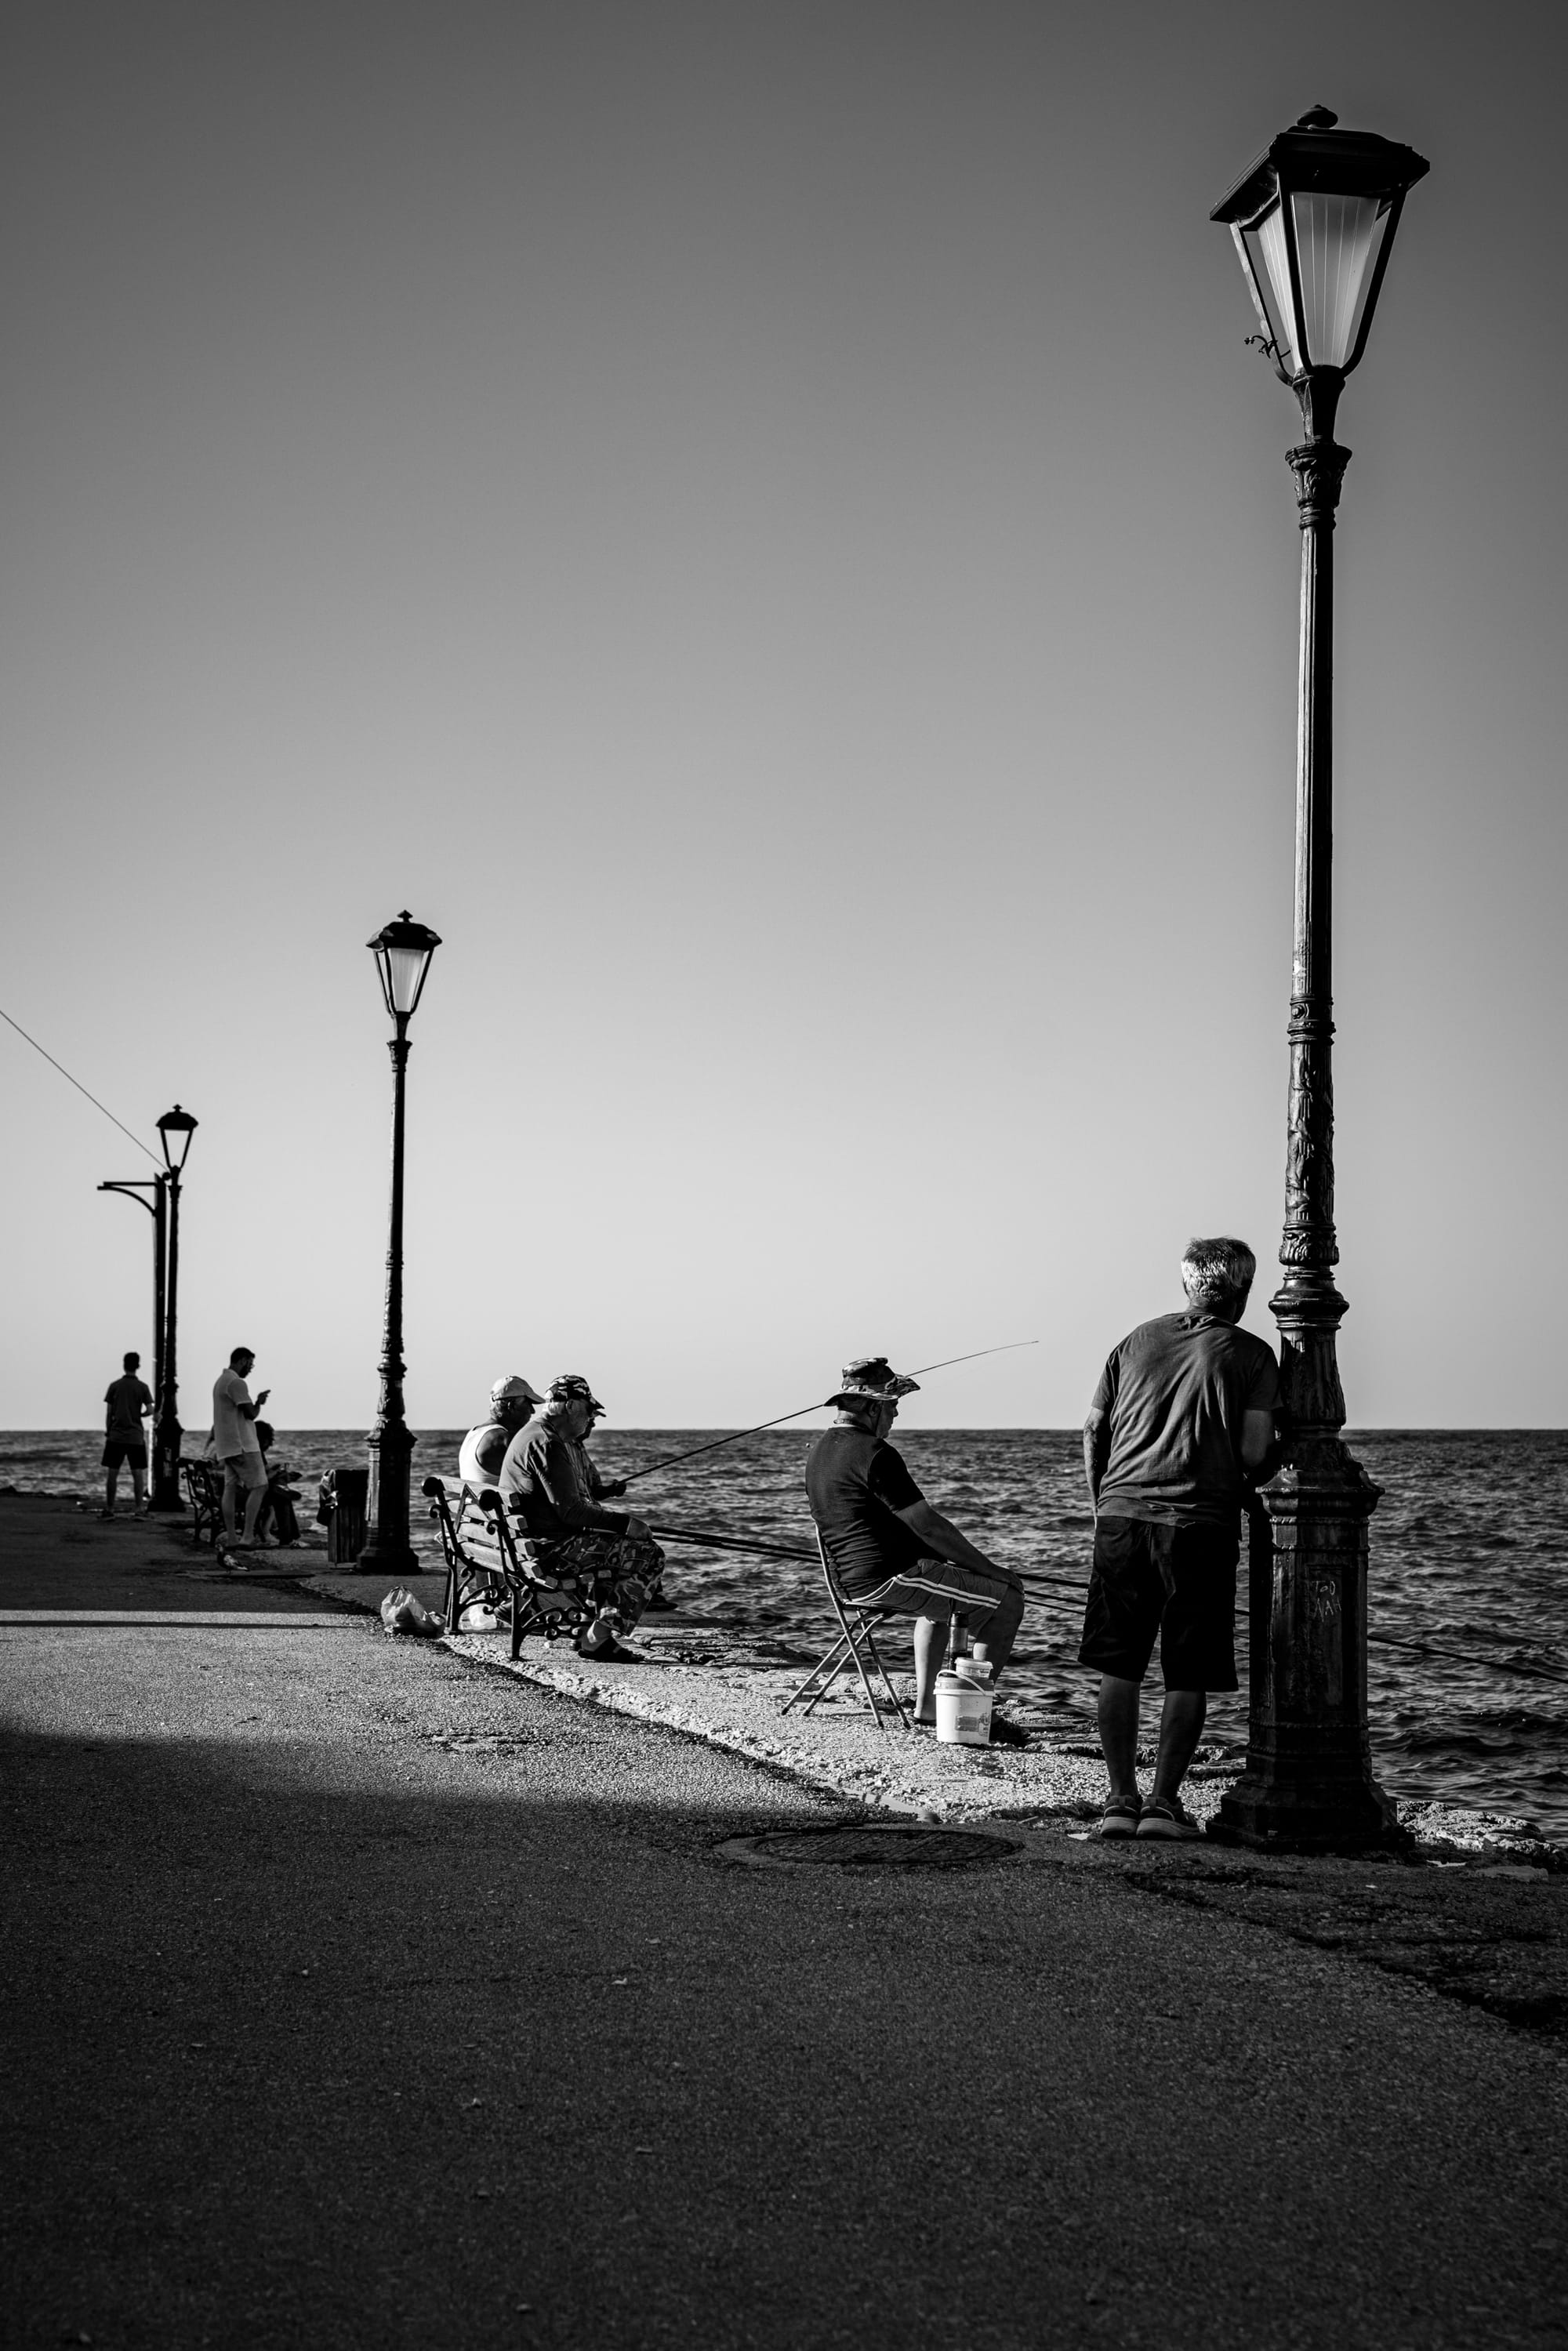
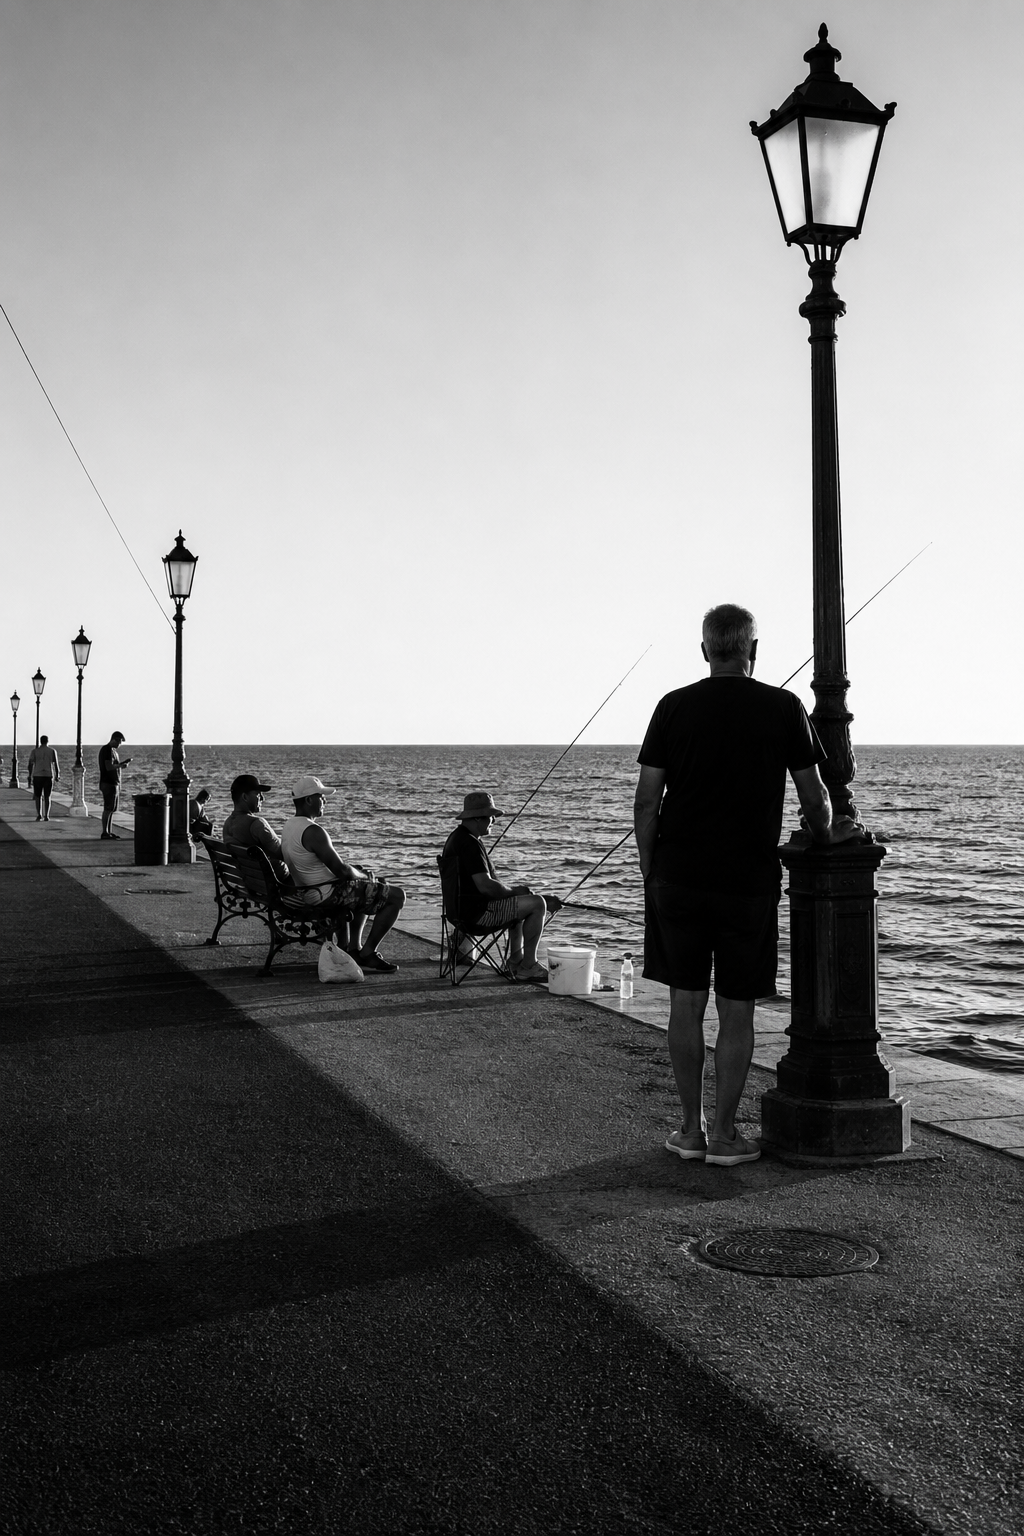
Bij een andere foto ging het nog verder. Een zwart-witfoto van een promenade met vissers, straatlantaarns en een enorme lege voorgrond werd helemaal ontleed. De positie van de lantaarn, de vissers, de hengels, de bankjes, de horizon, de schaduwen en zelfs een putdeksel kwamen terug in de prompt.
Claude was daarmee eigenlijk even geen chatbot meer, maar een soort digitale fotografie-analist.
En vervolgens gaf ik die prompts aan ChatGPT met één simpele opdracht: maak de foto.
En toen werd het interessant
De resultaten waren verrassend goed. Niet exact hetzelfde natuurlijk. Dat zou ook bijna onmogelijk zijn zonder de originele foto te gebruiken. Maar de AI wist de visuele structuur van de foto's behoorlijk goed te reconstrueren.
Bij de vuurtoren klopten de compositie, de warme verlichting, de donkere zee, de oranje lucht en zelfs de silhouetten van de mensen op de kade opvallend goed.
Bij de zwart-witfoto van de promenade gebeurde iets vergelijkbaars. De grote lantaarn rechts, de vissers langs het water, de diagonale kade, de lege donkere voorgrond en de horizon kwamen allemaal terug.
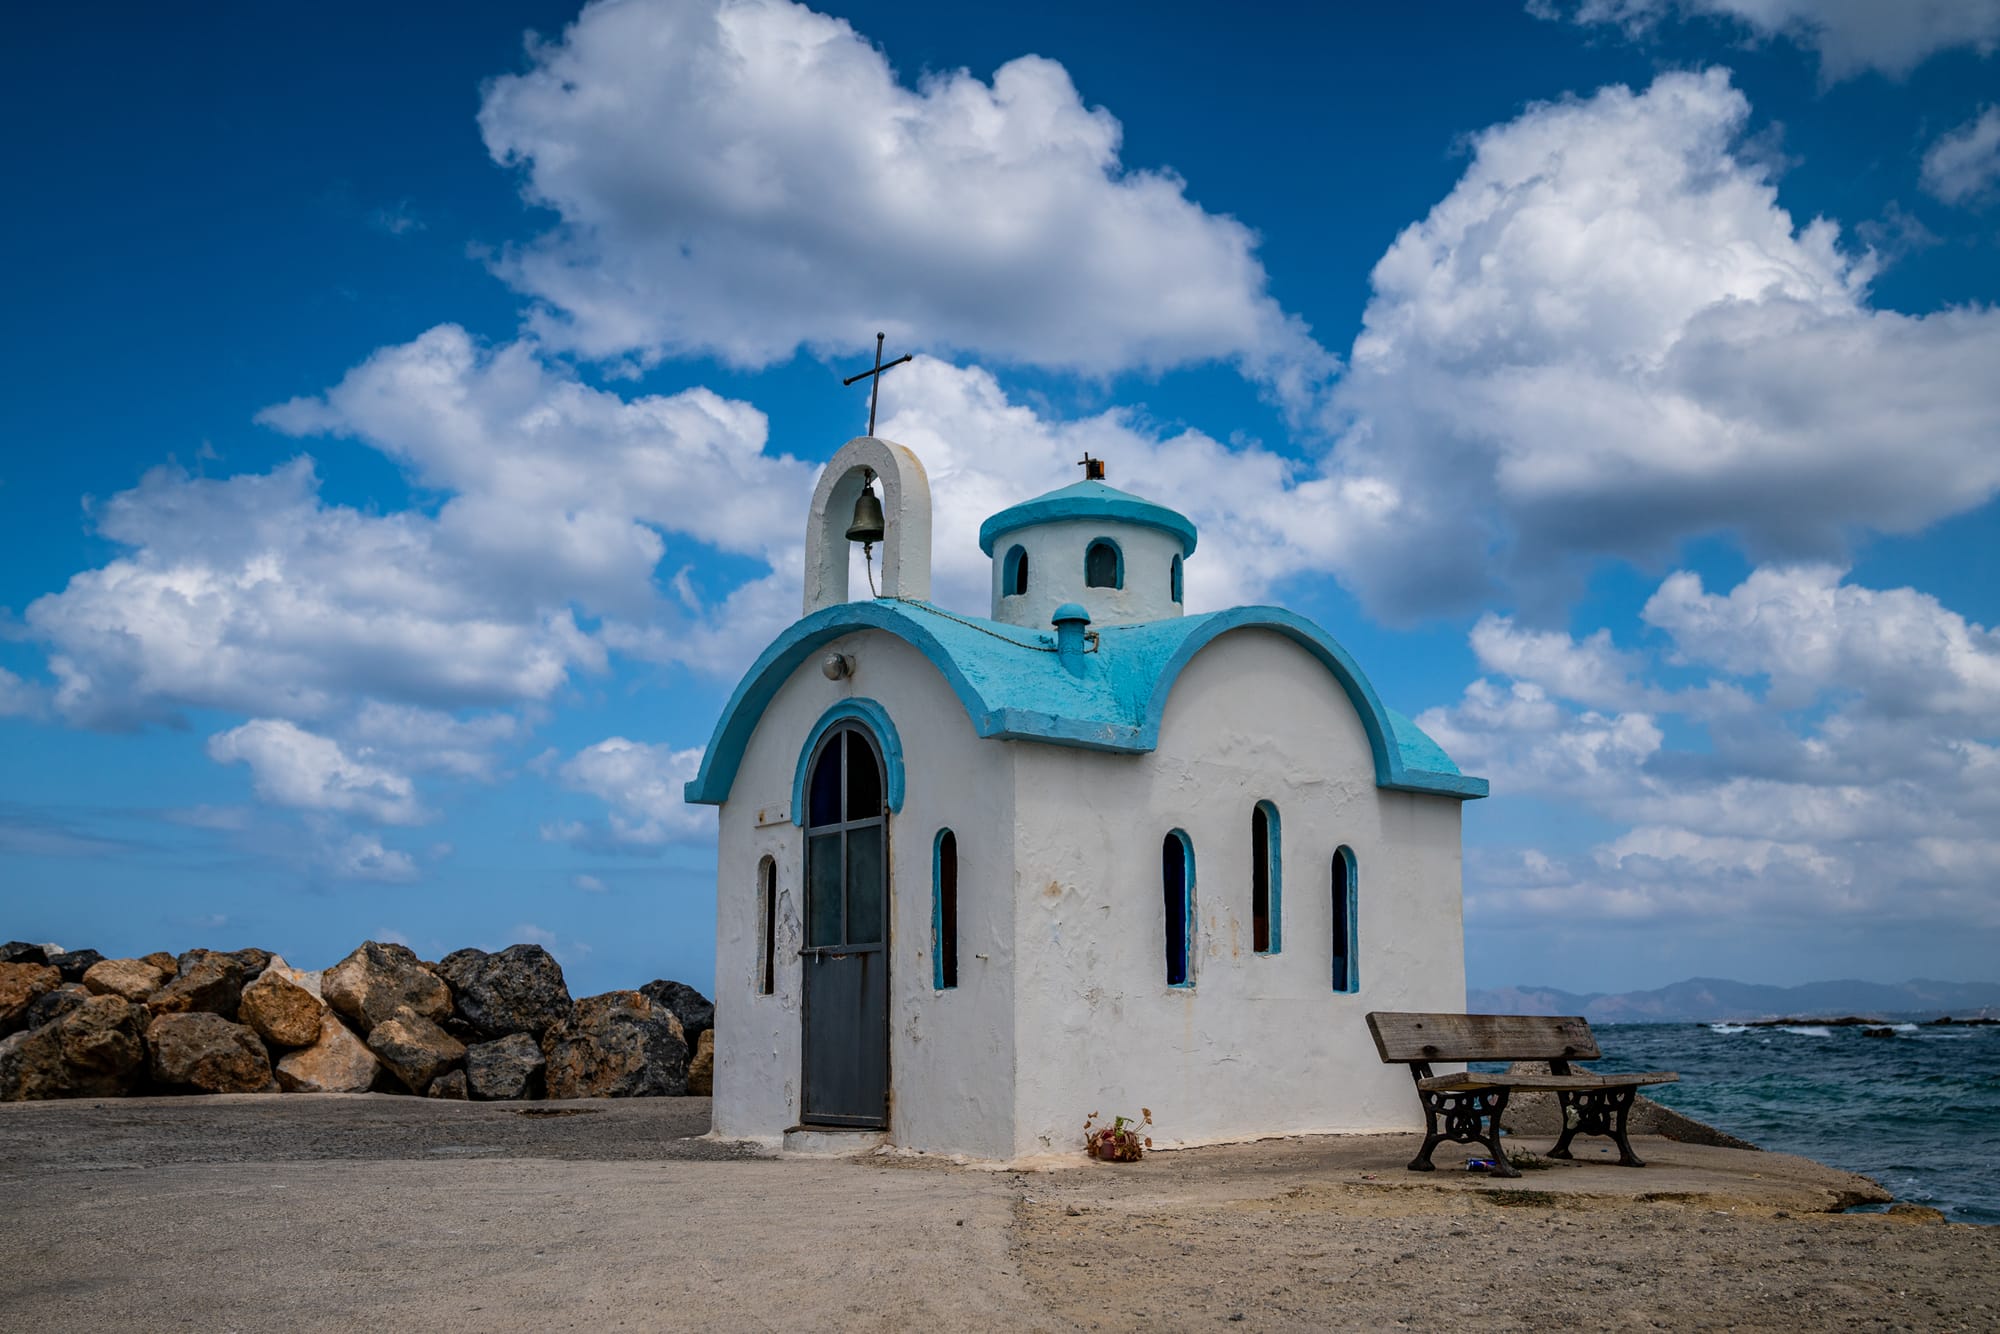
En toen kwam de derde foto: een kleine Griekse kapel aan zee. Ook daar wist Claude enorm veel details uit de foto te halen. De turquoise daken, de bel, het kruis, de verweerde witte muren, de rotsen, het bankje, de zee en zelfs de bergen op de achtergrond werden allemaal beschreven. ChatGPT maakte er vervolgens een behoorlijk overtuigende nieuwe foto van.
Maar…
AI maakt het soms mooier
En daar werd het voor mij als fotograaf pas echt interessant. Want de gegenereerde foto's zijn niet simpelweg fout. Ze zijn op een andere manier fout.
De AI begrijpt behoorlijk goed wat er op de foto staat, maar soms begrijpt hij minder goed waarom ik het als fotograaf zo in beeld heb gezet. De lege ruimte wordt bijvoorbeeld wat sneller opgevuld. Een persoon die in mijn originele foto onderdeel is van de compositie, wordt door AI ineens het hoofdonderwerp. En de kleine, verweerde Griekse kapel? Die werd door AI bijna een toeristische ansichtkaart. Net iets te mooi. Net iets te perfect.
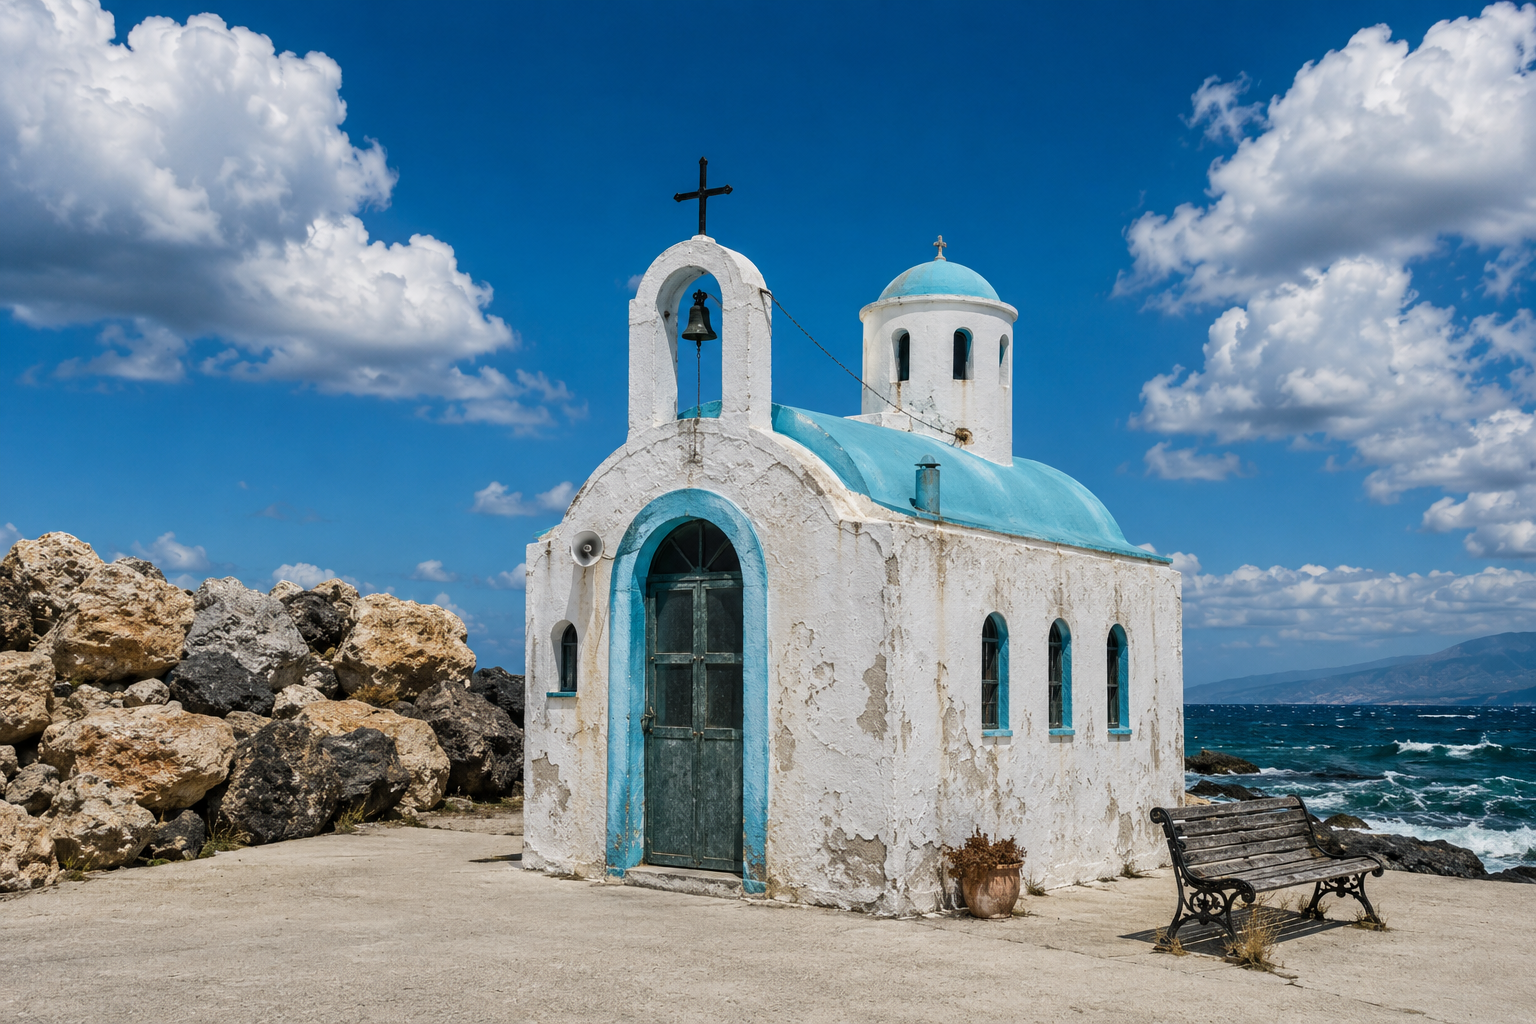
Terwijl het origineel juist interessant is omdat het een beetje rommelig, verweerd en alledaags is.
Dat zette me aan het denken.
Ziet AI wat ik zag?
Als fotograaf maak je een foto niet door bewust te denken: "De persoon moet op 72 procent van de horizontale as staan en de horizon moet op 63 procent van de beeldhoogte komen." Je ziet iets. Een moment. Een lijn. Een bepaalde lichtval. Een interessante compositie. En je drukt op de knop.
AI moet dat achteraf vertalen naar taal.
En misschien is dat precies wat deze test zo interessant maakt. Claude kan een foto ontzettend nauwkeurig beschrijven. ChatGPT kan die beschrijving vervolgens omzetten in een nieuwe afbeelding. Maar ergens onderweg ontbreekt nog iets.
De reden waarom de fotograaf de foto maakte.
AI ziet de stenen. AI ziet de zee. AI ziet de mensen. AI ziet het licht.
Maar ziet AI ook wat jij zag toen je op de ontspanknop drukte?
Fotograaf vs AI
Ik vind het daarom eigenlijk geen strijd tussen fotograaf en AI. Sterker nog: ik vind het een fascinerende samenwerking. De fotograaf maakt het beeld. Claude probeert te begrijpen wat er in dat beeld gebeurt. ChatGPT probeert het vervolgens opnieuw te maken.
En door de originele foto naast de AI-versie te leggen, krijg je ineens een interessante vorm van fotografie-analyse.
Niet alleen: "Hoe goed kan AI een foto namaken?"
Maar vooral: "Hoe goed begrijpt AI fotografie?"
En misschien is dat uiteindelijk een veel interessantere vraag.