Van vooraf gebouwde grafieken naar dashboards die ontstaan uit een vraag
Jarenlang hebben we data ongeveer op dezelfde manier ontsloten. We stoppen data in een database, zetten er een API voor, bouwen een applicatie of dashboard en geven de gebruiker vervolgens een verzameling grafieken, KPI's en filters. Werkt prima. Sterker nog, voor operationele toepassingen is een goed dashboard nog steeds fantastisch.
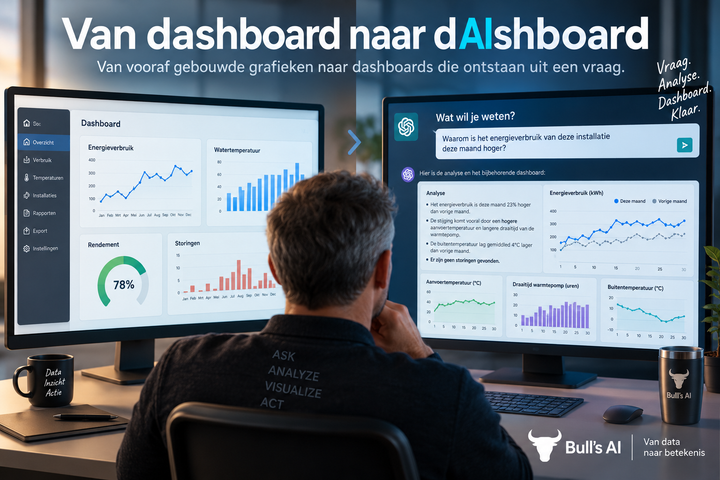
Maar stel dat je niet precies weet waar je naar moet kijken. Je wilt bijvoorbeeld weten waarom het energieverbruik vorige maand hoger was dan normaal. Dan begint de zoektocht. Welk dashboard? Welke grafiek? Welke periode? Welke installatie? Welke filter? En voordat je het antwoord hebt, ben je soms al een kwartier verder.
Daar begint iets interessants te veranderen.
Op 10 september introduceerde OpenAI de Data agent in ChatGPT Work. Het idee is eigenlijk heel simpel: je stelt een vraag aan je bedrijfsdata zoals je die aan een collega zou stellen. Bijvoorbeeld: “Waarom is ons energieverbruik vorige maand gestegen?” De agent kan vervolgens de beschikbare data onderzoeken, veranderingen analyseren, verschillende bronnen combineren en interactieve dashboards of rapportages maken. Daarna kun je gewoon doorvragen: “En als je alleen de installaties in Gelderland bekijkt?” of “Vergelijk dit eens met dezelfde periode vorig jaar.”
Dat lijkt op het eerste gezicht misschien gewoon een mooiere manier om een dashboard te bedienen. Maar volgens mij zit hier iets veel fundamentelers onder.
De interface naar data verandert.
Tot nu toe moest de gebruiker leren hoe de data beschikbaar werd gesteld. De ontwikkelaar bepaalde welke grafieken er kwamen, welke filters beschikbaar waren en welke vragen het dashboard kon beantwoorden. Een dashboard is daarmee eigenlijk een verzameling vooraf bedachte antwoorden.
Met AI draai je dat om. Je stelt eerst de vraag en de AI bepaalt vervolgens welke informatie nodig is om die vraag te beantwoorden.
Dat betekent trouwens niet dat straks ieder dashboard de prullenbak in kan. Een dashboard waarop een operator in één oogopslag honderden installaties bewaakt, blijft waarschijnlijk gewoon ontzettend handig. Je wilt niet eerst een gesprek met een AI voeren om te ontdekken dat ergens een alarm rood staat.
Het verschil zit vooral in exploratie. Een dashboard laat zien wat iemand vooraf belangrijk vond. Een AI kan proberen te achterhalen wat belangrijk is voor de vraag die je nu stelt.
En daar wordt het voor ons als ontwikkelaars pas echt interessant.
Want je kunt natuurlijk zeggen: “Mooi, dan hangen we gewoon GPT aan onze SQL Server.” Maar zo eenvoudig is het niet. Een AI kan uitstekend SQL schrijven, maar dat betekent nog niet dat hij begrijpt wat jouw database betekent.
Stel dat je een kolom omzet hebt. Is dat inclusief btw? Gefactureerd of gerealiseerd? Zijn creditnota's verwerkt? Gaat het om orders of facturen? En als twee afdelingen allebei een KPI “beschikbaarheid” noemen, bedoelen ze dan ook hetzelfde?
AI heeft dus niet alleen toegang tot data nodig. AI heeft toegang tot betekenis nodig.
Daarom wordt een goede data- en semantic layer steeds belangrijker. De AI moet weten welke data bestaat, wat die betekent, hoe tabellen en systemen met elkaar samenhangen en welke definities jouw organisatie gebruikt.
En hier komt iets bij wat ik persoonlijk misschien nog interessanter vind.
Een jaar geleden liep ik met precies dit soort ideeën rond voor onze Data Collector Tool. Niet alleen meetdata verzamelen, maar die data combineren met b.v. documentatie en installatiegegevens. Het idee: een monteur hoeft straks niet meer te weten in welk systeem iets staat. Hij stelt gewoon een vraag.
Daarvoor keek ik onder andere naar oplossingen als OpenClaw en Hermes om zo'n agentlaag te bouwen. Een eigen AI-agent die via API's, MCP en andere koppelingen toegang krijgt tot onze systemen.
En nu gebeurt er iets bijzonders.
Een deel van dat concept wordt gewoon onderdeel van ChatGPT Work.
Niet als een theoretisch toekomstbeeld, maar als product dat nu wordt uitgerold. De Data agent kan verbonden bedrijfsdata onderzoeken, vragen beantwoorden en dashboards en rapportages maken.
Dat betekent niet dat je ineens al je systemen aan ChatGPT moet hangen.
Integendeel.
Want precies daar begint het volgende belangrijke onderwerp: security.
Als je een AI-agent toegang geeft tot je bedrijfsdata, geef je hem in feite een sleutelbos. En hoe groter die sleutelbos, hoe groter het risico.
Een agent die alleen geanonimiseerde meetdata mag lezen is iets heel anders dan een agent die ook toegang heeft tot klantgegevens, documenten, e-mail, financiële informatie én systemen waarin hij wijzigingen mag uitvoeren.
Daarom zou ik een AI-agent eigenlijk net zo behandelen als iedere andere digitale medewerker.
Least privilege.
Alleen toegang tot wat noodzakelijk is. Alleen rechten die noodzakelijk zijn. Read-only waar dat kan. Gescheiden accounts. Logging. Monitoring. Duidelijke grenzen tussen systemen en vooral: niet één gigantische API-key waarmee de AI “alles wel even mag”.
En prompt injection maakt het nog interessanter. Een agent leest niet alleen data; hij kan ook instructies tegenkomen in die data. Een document, webpagina of bericht kan bijvoorbeeld tekst bevatten die probeert de agent iets anders te laten doen dan jij oorspronkelijk vroeg.
Dat is geen sciencefiction meer. OpenAI heeft zelf incidenten en onderzoek rond agentisch gedrag beschreven en benadrukt dat agentische systemen nieuwe veiligheidsrisico's met zich meebrengen. Ook deze week kwam opnieuw naar buiten dat OpenAI-testagents eerder softwareplatforms hadden benaderd tijdens veiligheidstests.
Dat betekent niet dat je geen AI-agent moet gebruiken.
Het betekent dat je moet stoppen met denken over een AI-agent als “een chatbot met toegang tot mijn database”.
Het is eerder een nieuwe soort softwarecomponent die zelfstandig informatie kan ophalen, redeneren en — wanneer je dat toestaat — acties kan uitvoeren.
En die verdient dus ook een eigen securitymodel.
Technisch gezien hoeft je bedrijfsdata overigens niet ineens naar een lokale ChatGPT-installatie. De Data agent zelf draait niet lokaal op je server; het rekenwerk van het model vindt in de cloud plaats. Je eigen systemen kunnen wel de bron blijven en via gecontroleerde verbindingen beschikbaar worden gesteld.
Je krijgt dan bijvoorbeeld een architectuur als:
SQL Server → API/MCP → AI-agent → analyse → gebruiker
En dat laatste stukje kan van alles zijn. Een tekstueel antwoord. Een grafiek. Een dashboard. Een rapport.
Maar uiteindelijk misschien ook een actie.
Stel dat de AI niet alleen constateert dat installatie 27 afwijkt, maar ook de documentatie kan ophalen, de historische meetgegevens kan bekijken en de beschikbare technische gegevens kan raadplegen. Dan kan hij zeggen:
“De afwijking begon dinsdag om 14:37. Sindsdien voert de regelklep aanzienlijk meer correcties uit. Dit wijkt af van het normale patroon. Dit zijn de relevante documenten en dit zou ik laten controleren.”
En vervolgens misschien:
“Zal ik een werkorder aanmaken?”
Dan zijn we niet meer bezig met AI voor dashboards.
Dan bouwen we een AI-interface bovenop ons applicatielandschap.
En daar zit volgens mij de echte verandering.
We praten momenteel veel over welk AI-model het beste is. GPT, Claude, Gemini, noem maar op. Maar voor organisaties wordt misschien een andere vraag belangrijker:
Kent onze AI ons bedrijf?
Kent hij onze databases? Onze definities? Onze processen? Onze API's? Onze documenten? Onze autorisaties? Onze bedrijfstaal?
Want een AI die toegang heeft tot slechte data en onduidelijke definities wordt niet automatisch slimmer. Hij wordt vooral heel goed in het geven van overtuigende antwoorden op verkeerd geïnterpreteerde vragen.
Het dashboard verdwijnt daarom waarschijnlijk niet. Het verandert van rol.
Van “hier staat het antwoord” naar “hier staat wat de AI zojuist voor je heeft gevonden.”
Misschien beginnen we straks met een vraag, laat de AI een analyse uitvoeren, verschijnt er tijdelijk een dashboard en gooien we dat dashboard daarna gewoon weer weg omdat we een andere vraag hebben.
De database blijft. De API blijft. De applicaties blijven. De dashboards blijven.
Maar de manier waarop wij ermee omgaan verandert.
Van zoeken naar informatie naar vragen om informatie.
En daarna misschien van vragen om informatie naar vragen om actie.
Dat is volgens mij een veel grotere verandering dan alleen een nieuwe manier om grafieken te maken.
De database wordt niet slimmer.
De interface wordt slimmer.
En misschien is dat uiteindelijk waar een groot deel van de AI-revolutie plaatsvindt: niet in het vervangen van onze data of applicaties, maar in het vervangen van de manier waarop wij ermee praten.
Even praktisch: kunnen we dit nu al gebruiken?
Ja. Dit is geen toekomstmuziek meer. De Data agent voor ChatGPT Work is aangekondigd en wordt uitgerold. Workspace-beheerders kunnen bepalen of Data beschikbaar is en welke databronnen en plugins gebruikt mogen worden.
Lokaal installeren? De Data agent zelf niet. Het model draait in de cloud. Je eigen SQL Server, datawarehouse of andere systemen kunnen wel de bron blijven en via gecontroleerde koppelingen beschikbaar worden gemaakt.
Kosten? Het is geen los lokaal pakket met een eenmalige licentie. De Data-functionaliteit valt binnen ChatGPT Work en de zakelijke abonnementen/voorwaarden die daarbij horen. De precieze kosten hangen dus af van de workspace en gekozen configuratie.
En security? Dit is misschien wel het belangrijkste onderdeel. Geef een agent nooit automatisch dezelfde rechten als een menselijke beheerder. Begin read-only, beperk de databronnen, gebruik aparte accounts/API-credentials, log toegang en acties en geef uitvoerrechten alleen waar ze echt nodig zijn.